ワークフローの継続的なキューイング
ワークフローイベントがトリガーされると、Kafkaメッセージキューにメッセージとして入り、その後、ワークフローの消費サービスによって処理されます。
プラットフォーム上でワークフローのキュー滞留が発生している場合、まず「キューは多いが徐々に消費されている」ケースと、「キューが停滞し全く消費されていない」ケースを切り分けることが重要です。
以下の2つのシナリオを想定してください:
- ワークフローがキューされ消費されている
- ワークフローがキューされているが消費されていない
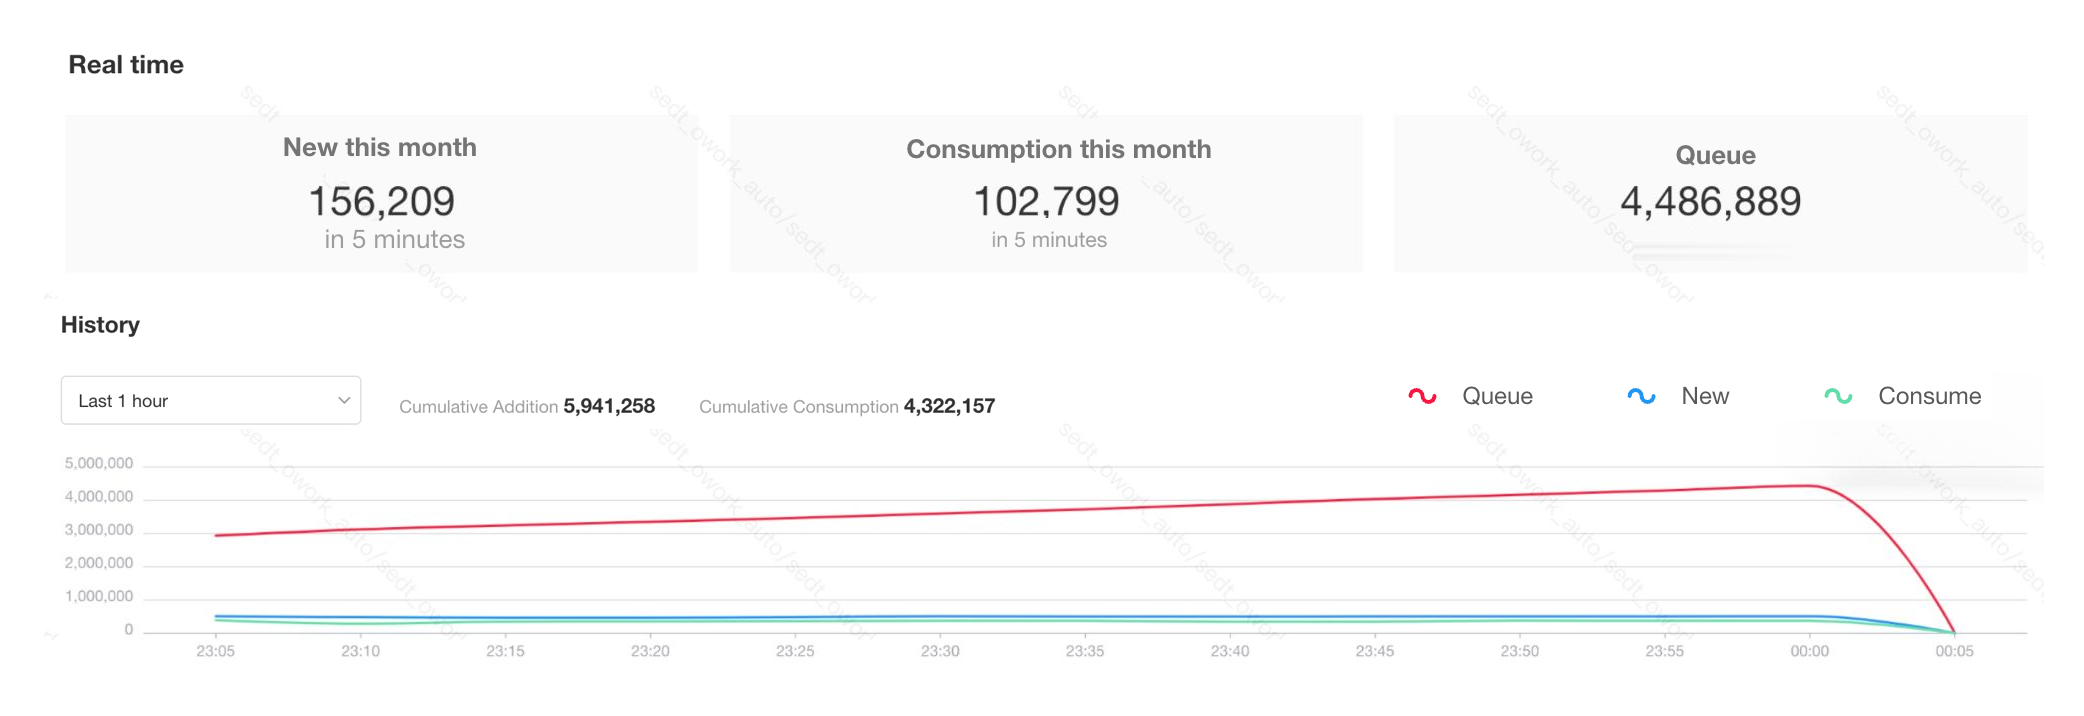
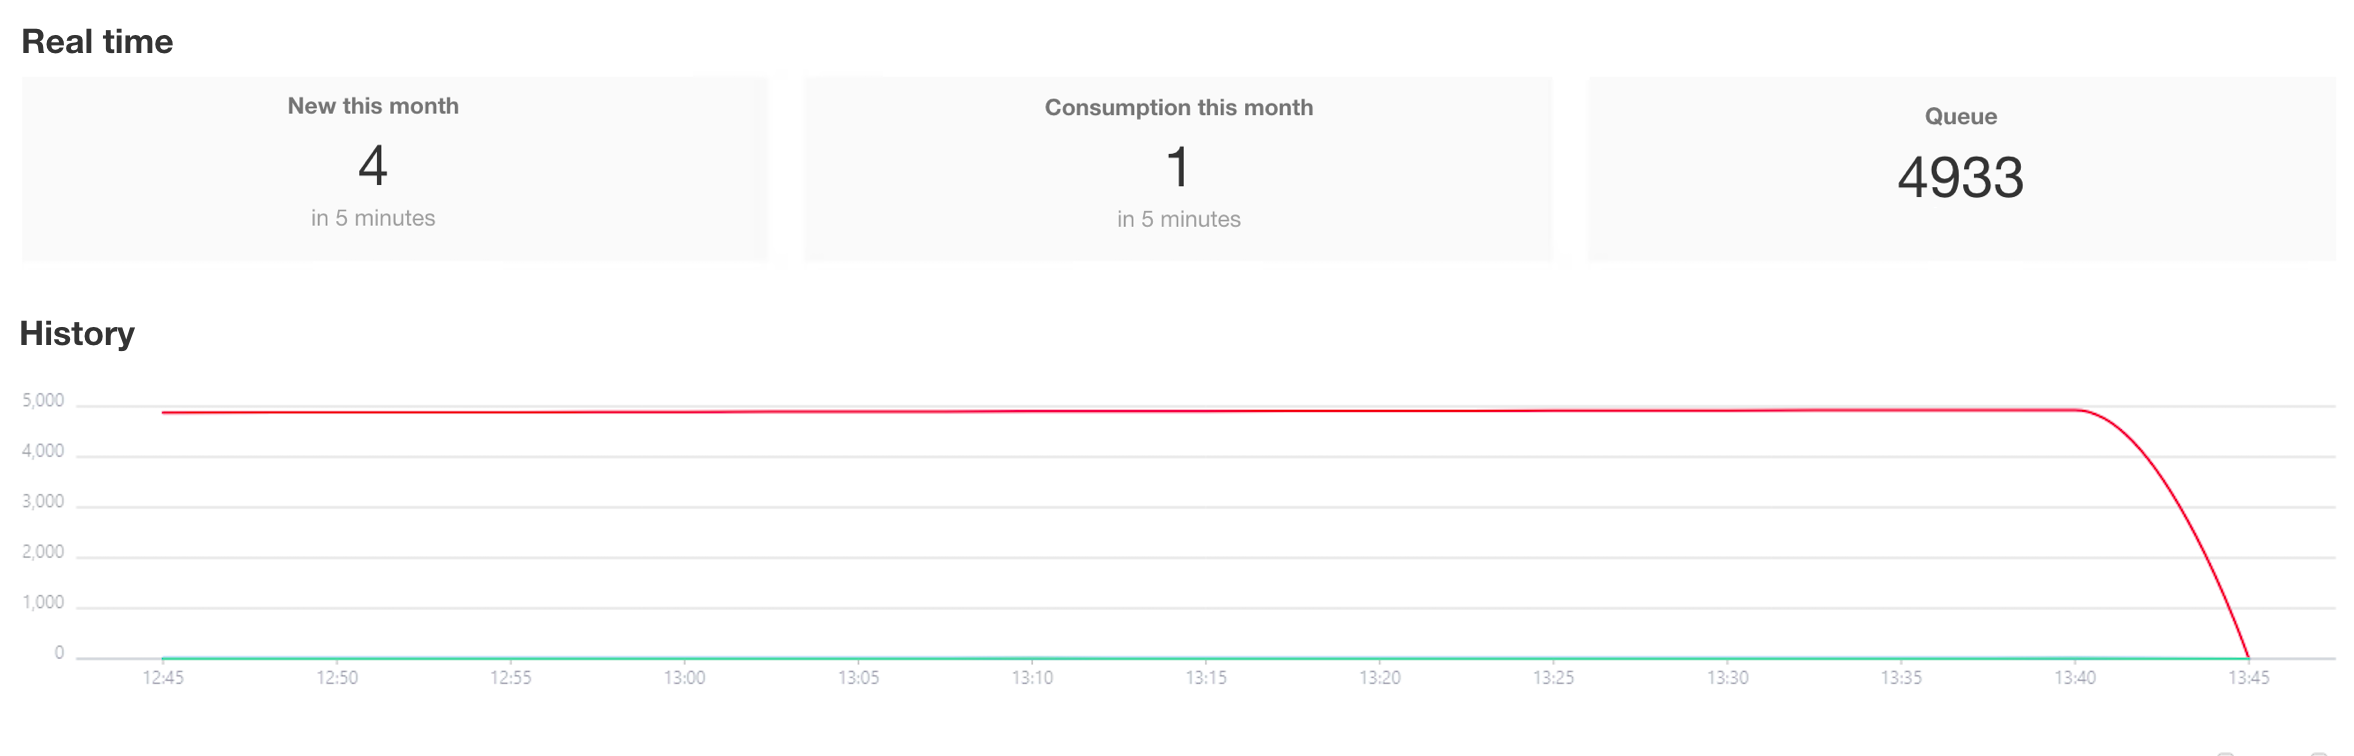
ワークフローがキューされ消費されている場合
ワークフローのモニタリングページで、何万件~数百万件規模の非常に大きなキューが発生しているか確認してください。これは、業務担当者によるトリガーロジックの誤設定や、ループによる大量のワークフロートリガーが原因となる場合があります。
消費能力にもさまざまな要因が影響します。例えば、通常は1分間に1万件のワークフローを処理できますが、何十万件ものワークフローが同時にトリガーされると、消費が追いつかずキューが膨らむことがあります。
一部のワークフローだけが数万件以上のキューになって全体のワークフローが著しく滞留している場合、これらのキューの多いワークフローが再度処理不要であれば非一時停止状態で直接クローズしてください。
- ワークフローを直接クローズすると、キュー内のワークフローはノードロジックを経由せず即座に消費され、早急に処理されます。
- 多量キューのワークフローを消費する必要がある場合は、一時停止し、業務の閑散時間帯に再開してください。
意図しない大量トリガーが発生していない場合は、サーバーにログインしてリソース利用状況を確認してください。topコマンドでリアルタイムのCPUおよびメモリ消費量を監視できます。
- CPUを大量に消費しているプロセスが
mongodであれば、これはスロークエリが原因であることが多いです。解決策はスロークエリ最適化をご参照ください。 dotnetやjavaプロセスがCPUを大量利用している場合、ワークフローノードの複雑なロジックがリソース消費増加の要因です。- サーバーリソースが逼迫している場合は、スケールアウトを行う、または複雑なロジックを含むワークフローの実行を業務の閑散時間帯に延期してください。
- Kubernetesクラスター型の環境でリソースに余裕があれば、消費量の多いサービスインスタンスのスケールアップを検討できます。
ワークフローがキューされているが消費されていない場合
ワークフローが継続的にキューされて消費されない場合、サーバーディスクのフルやKafkaサービスの障害が主な原因です。
- サーバーで
df -Thコマンドを使い、システムディスクおよびデータディスクの利用状況を確認します。 - Kafkaサービスが正常稼働しているか確認してください。
- 単体モード
- クラスターモード
ストレージコンポーネントのコンテナのヘルスチェックログを確認します。
docker logs $(docker ps | grep sc | awk '{print $1}')
- 通常はすべてINFOログです。Kafkaサービスが継続的に再起動し続けている場合、Kafkaサービスに障害が発生しています。まず全体の再起動をお試しください。Kafkaが起動しない場合は、Kafkaエラーデータのクリア手順をご参照ください。
Kafkaを導入しているサーバーで、現在のKafkaサービス状態を systemctl status kafka コマンドで確認します。
正常稼働時は「running」となっています。頻繁な再起動やfailed状態であれば、サービス異常です。
ディスクフルやKafka障害などで、トリガーされたワークフローがKafkaキューに正常に書き込めなかった場合、これらヒストリ上の「キュー済み」ワークフローは、今後も消費されません。
極めて稀なケースとして、Kafkaコンシューマグループがリバランス状態に入ることがあります。これは主にプロセス遅延によるタイムアウトや、コンシューマサービスインスタンスのリソース問題による再起動が発生した場合に、グループリバランスが発生します。
各トピックパーティションでの実際のメッセージ滞留状況やリバランス状態かどうかを、次のコマンドで確認できます。
- 単体モード
- Kubernetesクラスターモード
- ストレージコンポーネントのコンテナに入ります。
docker exec -it $(docker ps | grep sc | awk '{print $1}') bash
- md-workflow-consumerコンシューマグループの消費状況を確認します。
/usr/local/kafka/bin/kafka-consumer-groups.sh --bootstrap-server ${ENV_KAFKA_ENDPOINTS:=127.0.0.1:9092} --describe --group md-workflow-consumer
Error: Executing consumer group command failed due to nullのエラーが表示された場合は、Kafkaインストールパッケージのダウンロード後、展開してbin/kafka-consumer-groups.shで再度実行してください。
Kafkaが導入されているサーバーで、md-workflow-consumerコンシューマグループの消費状況を確認します。
/usr/local/kafka/bin/kafka-consumer-groups.sh --bootstrap-server 127.0.0.1:9092 --describe --group md-workflow-consumer
Connection to node -1 (/127.0.0.1:9092) could not be established. Broker may not be available.と表示された場合は、127.0.0.1 をローカルの内線IPに置き換え再度実行してください。
正常出力例は以下の通りです。Warning: Consumer group 'md-workflow-consumer' is rebalancing. と表示されている場合は、現在コンシューマグループがリバランス中です。
- 正常時
- リバランス中
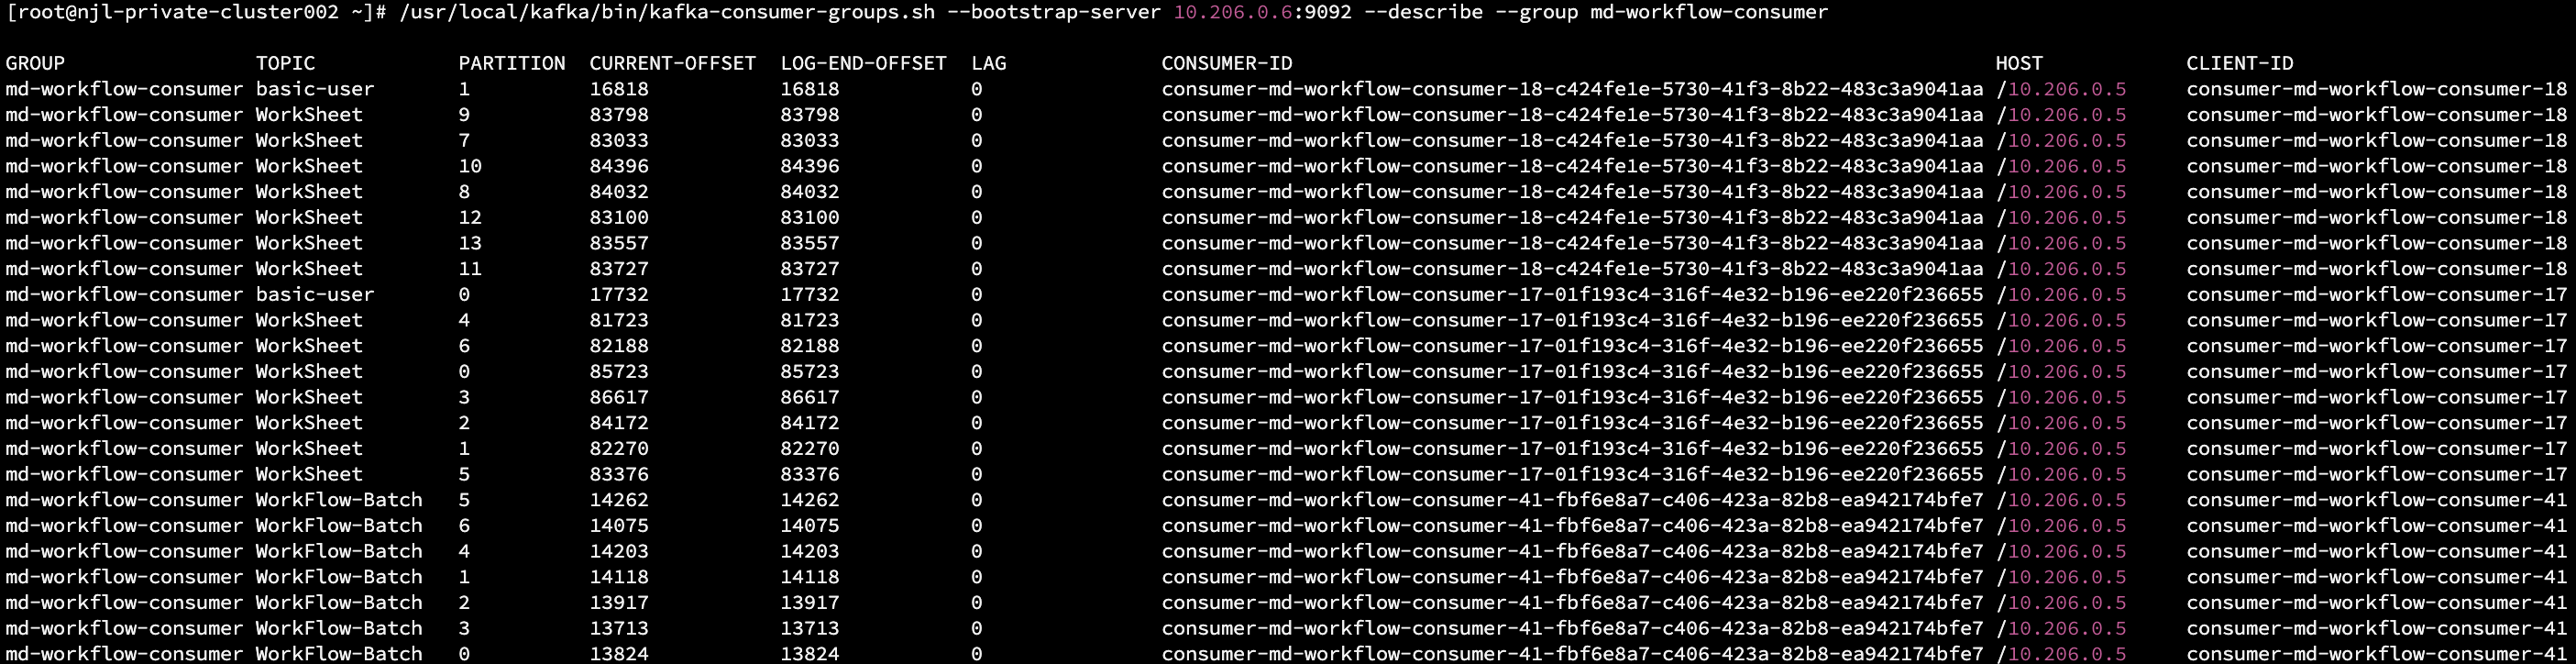
- LAG列はトピックパーティション内で現在滞留しているメッセージ数を表します。
- ワークフローでよく利用されるTopic名
- WorkFlow:メインワークフロー実行
- WorkFlow-Process:サブワークフロー実行
- WorkFlow-Router:ワークフロー実行の遅延キュー
- WorkFlow-Batch:バルクワークフロー実行
- WorkFlow-Button:ボタントリガーワークフロー実行
- WorkSheet:ワークフロートリガーとなる行データ検証
- WorkSheet-Router:行データ検証の遅延キュー
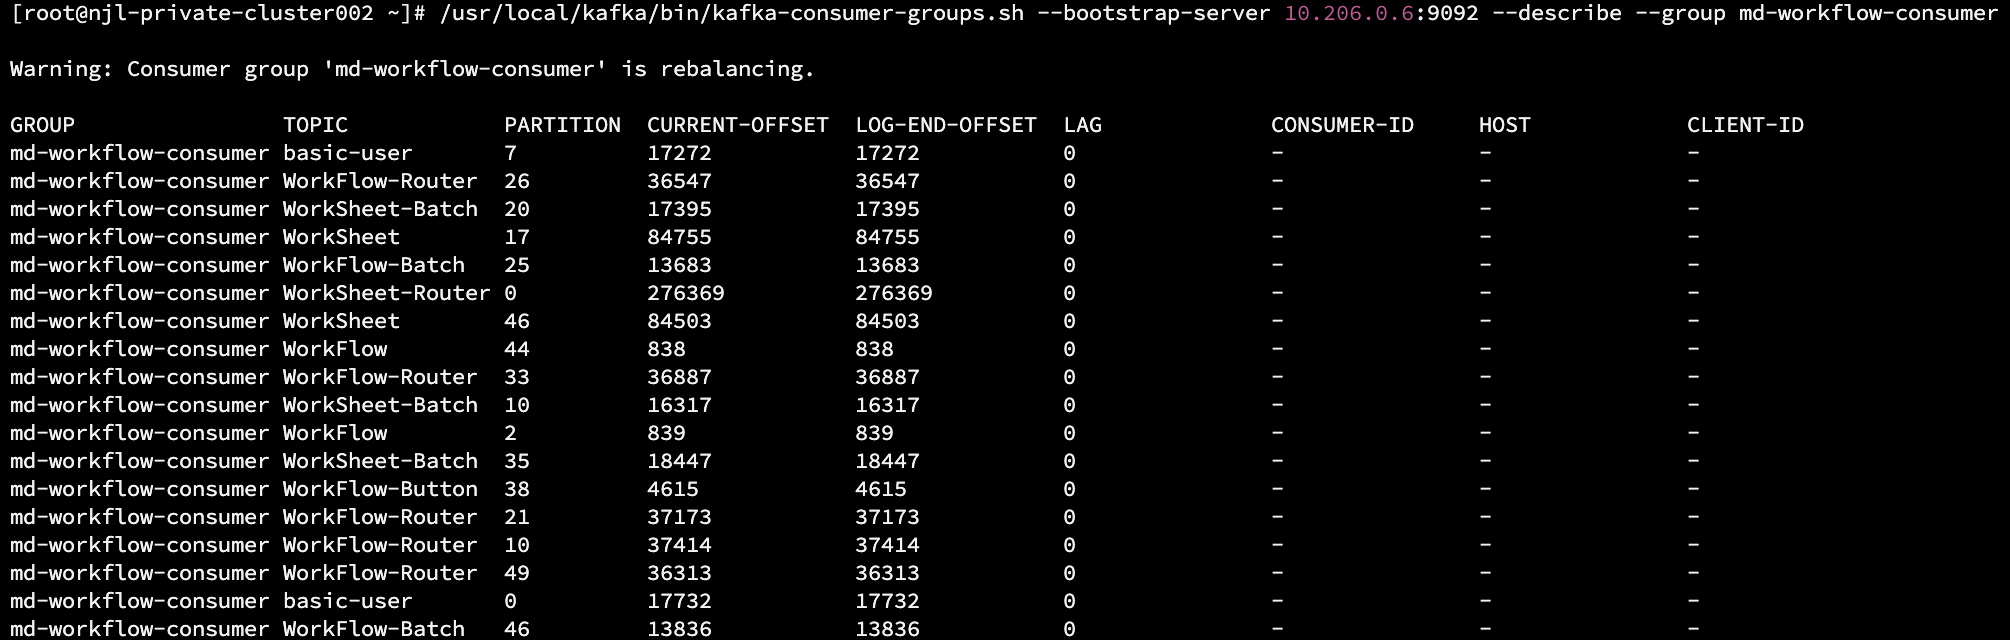
長時間にわたりリバランス状態が継続する場合、以下の手順でワークフロー消費サービスを再起動してください:
- 単体モード
- Kubernetesクラスターモード
- マイクロサービスのコンテナに入ります。
docker exec -it $(docker ps | grep -E 'hap-community|hap:' | awk '{print $1}') bash
- コンテナ内でワークフロー消費サービスを個別に再起動します。
source /entrypoint.sh && workflowconsumerShutdown
source /entrypoint.sh && workflowrouterconsumerShutdown
ワークフロー消費サービスを再起動します。
kubectl rollout restart deploy workflowconsumer
kubectl rollout restart deploy workflowrouterconsumer