ログデータをシャーディングクラスターに保存する
レプリカセット構成では、各ノードにデータ全体のコピーを保存する必要があります。運用を続けるとログデータが蓄積し、特に次のデータは TB 規模に達しやすくなります。
- ワークシートのレコード変更ログ
- ワークフローの実行履歴ログ
ログデータが増え続けると、レプリカセットだけではストレージコストとクエリ負荷が高くなります。履歴データの定期削除やアーカイブに加えて、MongoDB のシャーディングクラスターによるログデータの水平分割も利用できます。
適用シーン
ログデータのシャーディングクラスターは、次のような場合に適しています。
- ログデータの増加が速く、単一の MongoDB レプリカセットのストレージ負荷が高い
- ワークシートの変更ログやワークフローの履歴ログが数百 GB~TB 規模に達している
- ログ検索時に、単一テーブルのデータ量が多すぎて応答時間が大幅に長くなっている
- ノードを追加してログデータの保存容量を段階的に拡張したい
現在のログデータが少ない場合や、既存の削除・アーカイブ方針で容量要件を満たせる場合は、まずそれらの方法を優先し、シャーディングクラスターを早期に導入して運用を複雑にすることを避けてください。シャーディングクラスターでは、デプロイ、監視、バックアップ、障害対応が複雑になります。導入前にログの規模、増加傾向、クエリのパターン、運用体制を評価し、テスト環境でシャードキー、インデックス、代表的なクエリの性能を検証してください。
アーキテクチャ
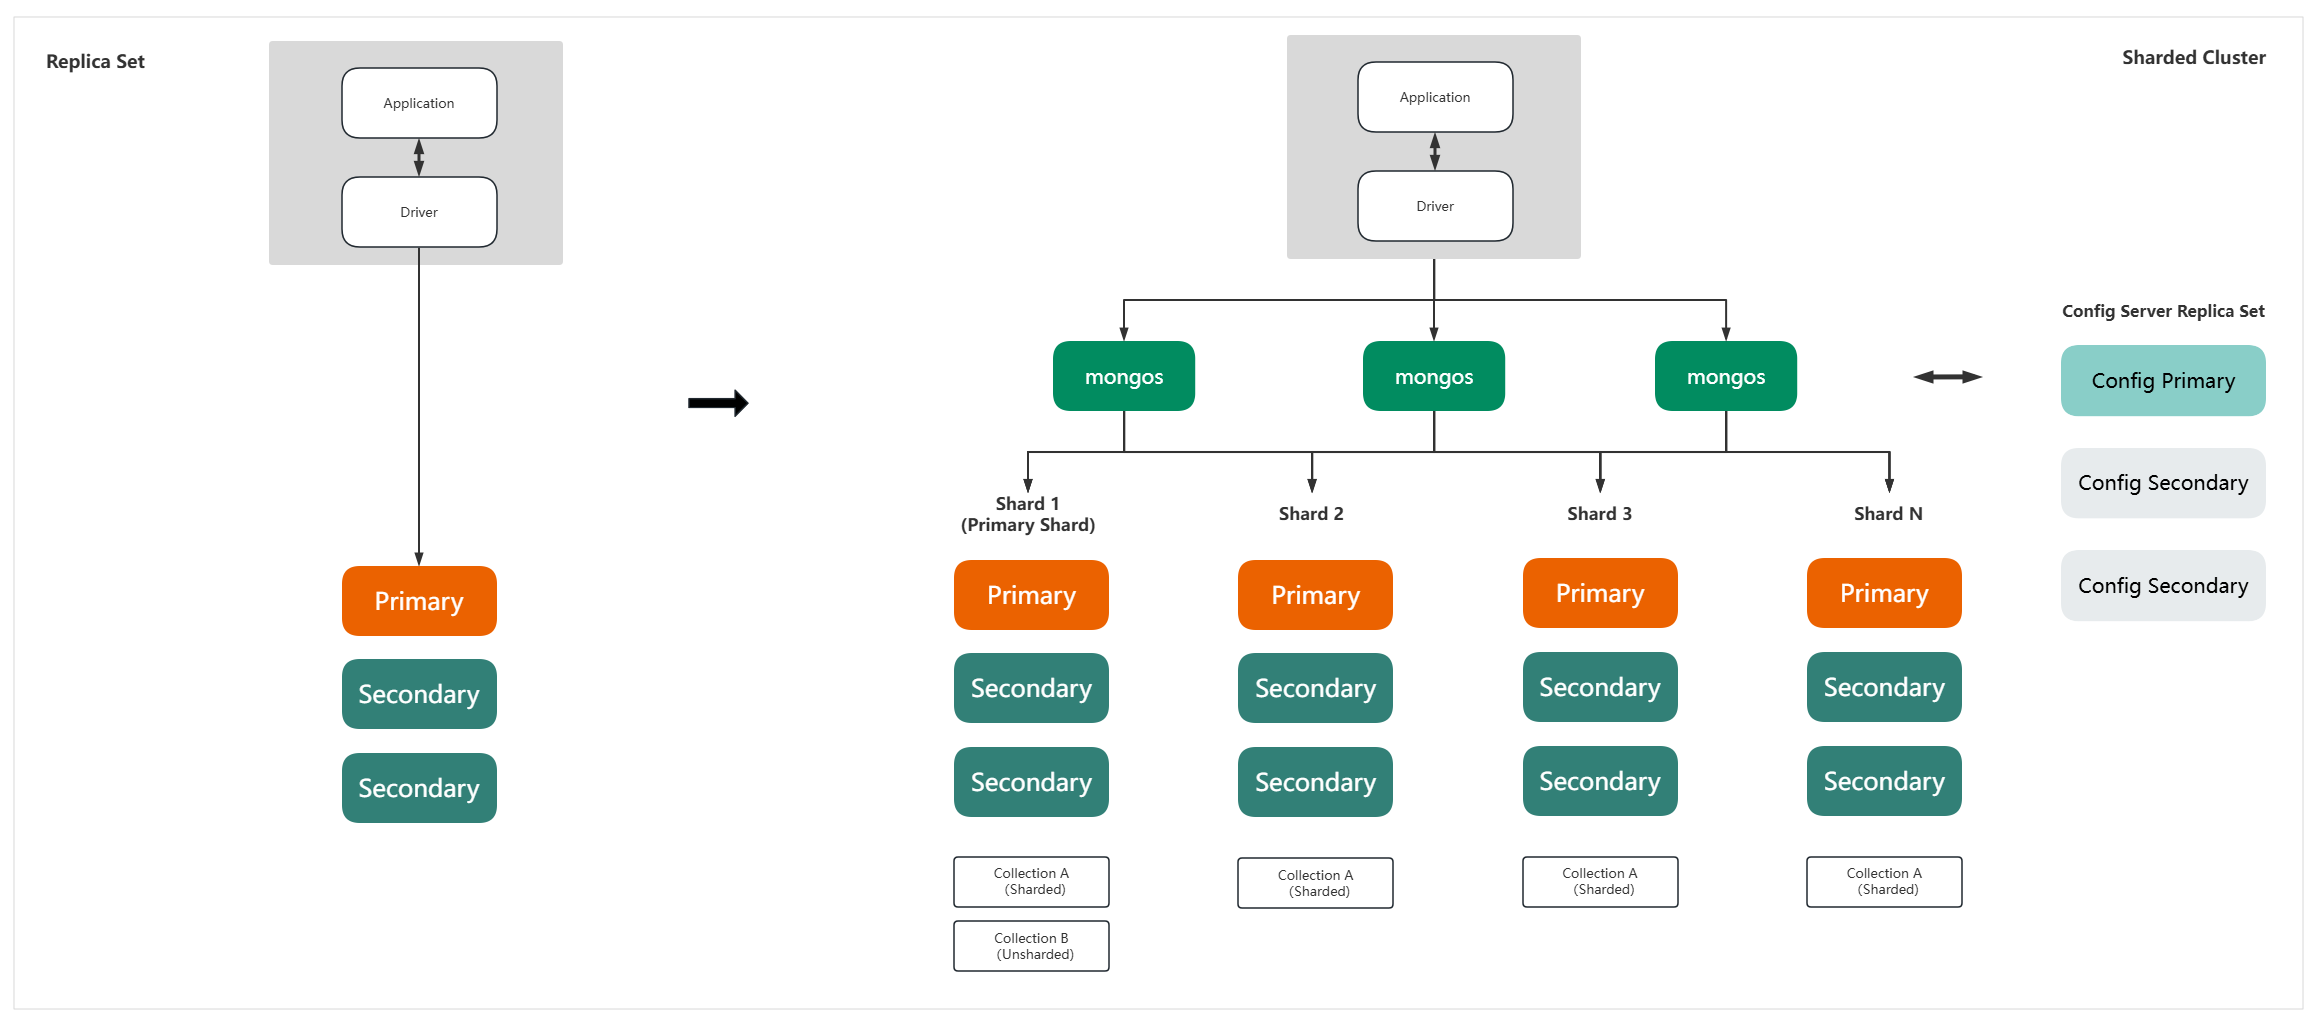
ログデータのシャーディングクラスターは、MongoDB Sharding によって大規模なログコレクションを複数のシャードに分割します。各シャードにはログデータの一部を保存し、ルーターが読み書きのリクエストを該当するシャードに転送します。
一般的な構成には、次のコンポーネントが含まれます。
- Config Server:シャーディングクラスターのメタデータとルーティング情報を保存します。
- Mongos:クエリのルーティング窓口として、対象シャードにリクエストを振り分けます。
- Shard:ログデータを保存します。通常、各シャードは可用性を確保するためにレプリカセットで構成します。
この構成では、ログデータが単一のレプリカセットに集中しません。データ量の増加に合わせて Shard を追加することで、全体のストレージ容量と I/O 性能を拡張できます。
主な利点
水平スケーリング
シャード数を増やしてログデータの保存容量を拡張できるため、単一の MongoDB ノードを継続的に増強する必要がありません。長期間蓄積するログデータも、シャーディングクラスターによって各シャードのデータ量を管理可能な範囲に抑えられます。
クエリ性能
クエリ条件がシャードキーに一致する場合、Mongos は対象シャードにリクエストを転送し、不要なデータスキャンを減らせます。複数のシャードをまたぐクエリでも、並列に処理することで、単一コレクションのデータ量増加による性能低下を抑えられます。
コスト管理
シャーディングクラスターは、必要に応じて拡張できます。現在のデータ量に合わせて初期のシャード数を決め、ログの増加に応じて段階的に追加することで、単一ノードに過大なストレージや計算リソースを最初から割り当てずに済みます。